資料
SpotClue 地理線索分析平台
結合可驗證的地理線索與瀏覽器端模型推論,分析街景照片的候選國家與區域。
- Python
- FastAPI
- PostgreSQL
- PostGIS
- osm2pgsql
- scikit-learn
- ONNX Runtime
- Transformers.js (WebGPU)
- React
- TypeScript
- Vite
- MapLibre GL
- Vitest
- Playwright
- Docker
- GitHub Actions
- SQL
- Pydantic
- SQLAlchemy
- Alembic
- REST API
- Docker Compose
- Pytest
- 國家分類 Top-5 準確率
- 79.3%
- 188 個國家,以 1,000 張未參與訓練的照片評估
- 有輸出時的 Top-5 命中率
- 97%
- 通過信心門檻的 47% 照片,正確國家在前五個候選內
- 瀏覽器內每張照片的推論時間
- 約 0.3 秒
- 4-bit CLIP ViT-L/14(199 MB),M4 MacBook/Chrome/WebGPU,排除首次推論
專案簡介
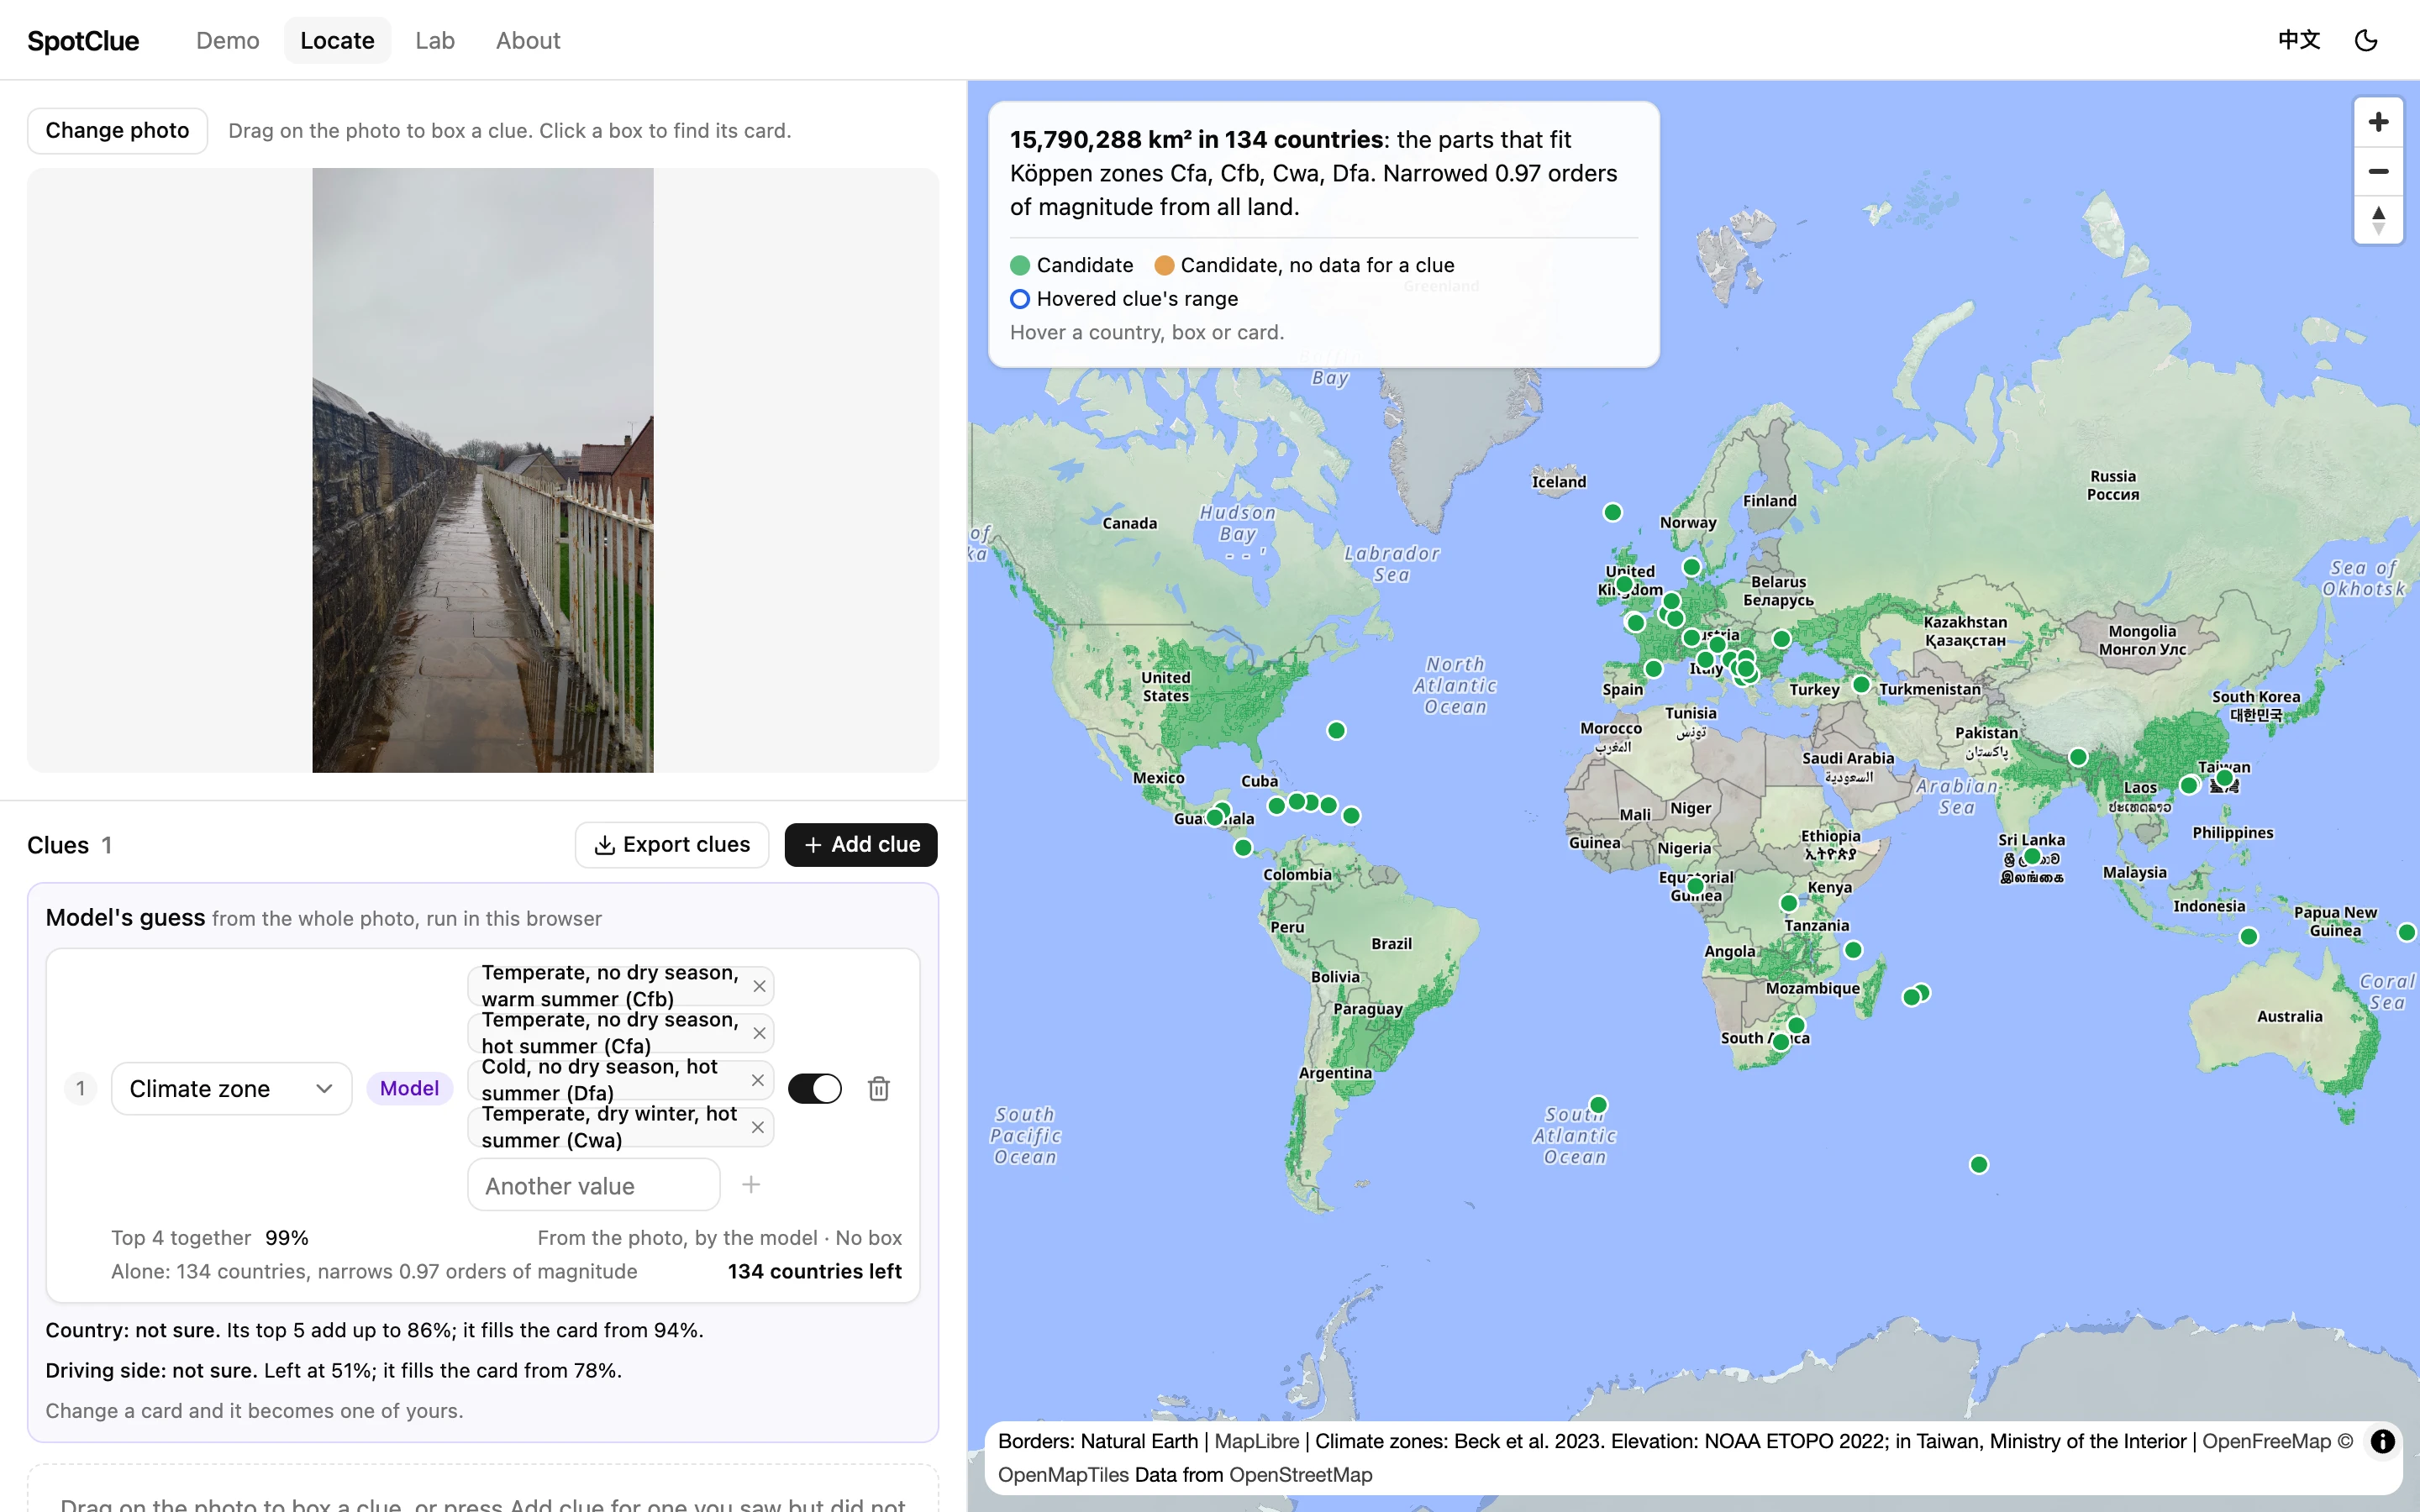
SpotClue 是已上線的個人專案,以可驗證的證據分析街景照片的拍攝地點。照片裡的每條線索(文字系統、道路標誌、地形、氣候帶)各自形成地圖範圍,再取交集得出候選的國家與區域。每條線索都能關閉或修改,地圖上會顯示範圍與矛盾之處。
- 開發前先做六個小型實驗(LLM 與 CLIP 基準、OCR、圖資涵蓋率、電桿號碼公式),用實測數字決定專案範圍。
- 線索判讀以規則優先。模型必須在同一組測試照片上高出 5 個百分點才採用,最後才考慮 LLM。
- 建立可重複執行的資料載入流程,把 OpenStreetMap、國家邊界、氣候分區與高程資料匯入 PostGIS,並預先算好氣候、海拔與地形分類,API 查詢階段進行篩選與面積加總。
- 為了讓照片留在使用者的裝置上,模型在瀏覽器內執行。將 CLIP ViT-L/14 影像編碼器匯出為 ONNX,比較 int8、fp16 與 4-bit 三種版本後採用 4-bit(199 MB,量化比較中的 Top-5 下降 1.1 個百分點)。在 M4 MacBook 的 Chrome/WebGPU 上以 20 張照片測試,排除首次推論後,時間中位數約 0.3 秒,不包含模型下載與載入時間。
- 凍結 CLIP 影像編碼器,以 46,785 張街景照片訓練線性國家分類頭。依地區分組切出驗證集,校準候選清單的信心門檻,僅在通過信心門檻時自動填入線索。
線索合併時,明確區分不符合條件與缺少資料的國家,缺資料者仍保留為候選。多條線索互相矛盾時,系統找出造成候選範圍為空的一組線索,協助使用者檢查線索判讀的依據。瀏覽器推論在 Web Worker 執行,WebGPU 無法使用或載入失敗時可退回 WASM;Python 評估與前端共用前處理設定。
國家分類器在 1,000 張未參與訓練的照片上,188 個國家的 Top-1 為 55.5%、Top-5 為 79.3%。加上信心門檻後,模型在約 47% 的照片中輸出前五個候選國家,其中約 97% 的候選清單包含正確國家。以 165,788 筆台電資料驗證電桿號碼換算座標的公式,誤差中位數約 10 公尺。做法與限制連同數據一併公開。